
Kryteria wyboru RAG w systemach firmowych
15 września 2025 · 2 min czytania
Retrieval-Augmented Generation łączy model językowy z wyszukiwaniem we własnych dokumentach organizacji. Artykuł porządkuje kryteria, kiedy RAG ma uzasadnienie, kiedy wystarcza prostsze rozwiązanie, i wskazuje ryzyka z listy OWASP dla aplikacji LLM, które dotyczą indeksu dokumentów.

Pojęcie Retrieval-Augmented Generation (RAG) opisali Patrick Lewis i współautorzy w pracy przyjętej na konferencję NeurIPS 2020. Model generatywny korzysta w niej z wiedzy zapisanej w parametrach oraz z zewnętrznego indeksu dokumentów przeszukiwanego przy każdym zapytaniu.
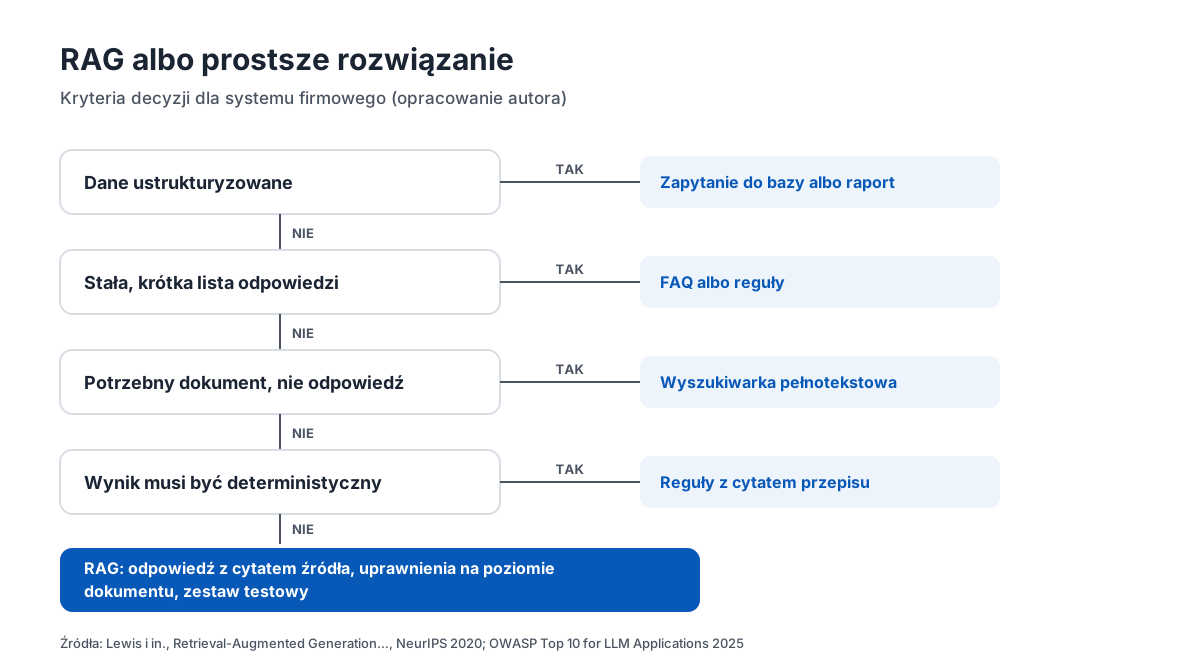
W systemie firmowym RAG pozwala odpowiadać na podstawie regulaminów, umów i dokumentacji technicznej bez ponownego trenowania modelu. Nie każde pytanie użytkownika wymaga jednak modelu językowego, dlatego artykuł zestawia kryteria decyzji (opracowanie autora).
W artykule
Warunki, w których RAG ma uzasadnienie
RAG ma sens, gdy wiedza potrzebna do odpowiedzi zmienia się częściej, niż opłaca się zmieniać model, a odpowiedź musi wskazywać dokument, z którego pochodzi. Dotyczy to zwłaszcza zbiorów nieustrukturyzowanych: procedur, umów, notatek technicznych i korespondencji, o które użytkownicy pytają własnymi słowami.
Wartość takiego zastosowania polega na skróceniu drogi do właściwego fragmentu dokumentu i na możliwości sprawdzenia go przez człowieka (opracowanie autora).
Prostsze rozwiązania dla części pytań
Jeżeli dane są ustrukturyzowane, odpowiedź daje zapytanie do bazy albo raport. Krótka i stała lista odpowiedzi mieści się w FAQ albo w regułach. Gdy użytkownik szuka dokumentu, a nie odpowiedzi, wystarcza wyszukiwarka pełnotekstowa. Jeżeli wynik musi być deterministyczny, na przykład przy kwotach i terminach, lepiej sprawdzają się reguły z cytatem źródła.
RAG pozostaje rozwiązaniem dla pytań, które nie przechodzą żadnego z tych filtrów (opracowanie autora).
Ryzyka indeksu dokumentów
Lista OWASP Top 10 for LLM Applications 2025 zawiera trzy pozycje szczególnie istotne dla RAG. LLM08 Vector and Embedding Weaknesses dotyczy słabości osadzeń i indeksu wektorowego. LLM01 Prompt Injection obejmuje także instrukcje ukryte w treści dokumentów, które trafiają do kontekstu modelu. LLM02 Sensitive Information Disclosure dotyczy ujawnienia informacji, do których pytający nie powinien mieć dostępu.
W praktyce oznacza to sprawdzanie uprawnień do dokumentu już w chwili wyszukiwania oraz traktowanie treści dokumentów wyłącznie jako danych dla modelu (opracowanie autora).
Pomiar jakości odpowiedzi
Przed wdrożeniem warto przygotować zestaw pytań testowych z oczekiwanym dokumentem źródłowym dla każdego z nich. Miarą jest odsetek odpowiedzi, które wskazują właściwe źródło, oraz zachowanie systemu, gdy źródła brak: odmowa odpowiedzi jest wtedy wynikiem poprawnym. Ten sam zestaw uruchamia się po każdej zmianie modelu, podziału dokumentów albo indeksu (opracowanie autora).
Źródła
- P. Lewis i in., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, NeurIPS 2020 – arxiv.org/abs/2005.11401
- OWASP, Top 10 for LLM Applications 2025 – genai.owasp.org/llm-top-10/
Najważniejsze wnioski
- RAG ma uzasadnienie, gdy wiedza zmienia się często, a odpowiedź musi wskazywać dokument źródłowy.
- Dane ustrukturyzowane, stała lista odpowiedzi i wyszukiwanie dokumentów obsługują prostsze narzędzia niż model językowy.
- Uprawnienia do dokumentów trzeba sprawdzać w chwili wyszukiwania, bo treść trafia do kontekstu modelu.
- Zestaw pytań testowych z oczekiwanym źródłem pozwala porównać jakość przed zmianą i po zmianie systemu.
Kolejne kroki
- Podział pytań użytkowników na grupy według schematu decyzji i wybór narzędzia dla każdej grupy.
- Przypisanie do każdego dokumentu w indeksie metadanych źródła, daty i uprawnień.
- Przygotowanie zestawu pytań testowych z oczekiwanym dokumentem źródłowym.
- Przegląd ryzyk LLM01, LLM02 i LLM08 z listy OWASP dla planowanego rozwiązania.